Animal Behavior
Digitally-enhanced dog behavioral testing
Digitally-enhanced dog behavioral testing
- 저자: Farhat N; Lazebnik T; Monteny J; Moons CPH; Wydooghe E; van der Linden D; Zamansky A
- 출처: - (2023)
- DOI/링크: https://doi.org/10.1038/s41598-023-48423-8
- 연구 계열: Topics/Animal Behavior
- 투고일: 2023-07-26
TL;DR
스트레인저 테스트에서 개의 이동 궤적을 영상으로 추적해 비지도 군집화한 결과 두 군집이 나왔고, 전문가 점수의 0/+ 구분과 잘 맞았으며 C-BARQ 낯선 사람 대상 공포에서만 군집 간 차이가 있었다. 전문가 점수를 예측하는 분류 모델의 정확도는 78.7%였다.
1. 연구 배경 및 동기
- 다루는 문제: 개의 행동 특성은 번식 선발, 입양 가능성, 작업 적성 예측에 쓰이지만 대부분 설문이나 관찰에 의존해 시간과 전문성이 필요하고 주관과 편향에 취약하다.
- 기존의 공백 / 왜 필요한가: 기존 컴퓨터 기반 연구는 사람이 고른 특징으로 기계학습을 했고, 사람의 개입 없이 행동 프로파일을 찾아 전문가 점수와 비교한 엄격히 통제된 행동 검사 연구는 없었다.
2. 관련 연구
- 기존 연구 흐름: 행동 검사(Strange Situation Test 등)와 설문(C-BARQ, Monash 설문 등)이 널리 쓰이며, 설문은 효율적이지만 주관성과 보호자와의 유대에 따른 편향이 있다. 같은 연구진의 BLYZER는 이전에 일부 데이터에서 수동으로 고른 특징으로 군집화에 쓰였다.
- 이 논문의 위치: 사람 없는(human-free) 궤적 기반 군집화로 행동 프로파일을 찾고 그것으로 전문가 점수와 C-BARQ를 예측하는, 탐색적 사례 연구이다.
3. 핵심 기여
- Faster R-CNN 기반 BLYZER로 추적한 궤적을 오토인코더와 시계열 K-means로 군집화해 사람 없는 행동 프로파일을 얻었다.
- 군집이 전문가의 0과 + 점수를 구분하며 C-BARQ 낯선 사람 대상 공포와 연관됨을 보였다.
- 전문가 점수 분류(정확도 0.787)와 C-BARQ 범주 회귀 모델을 제시했다.
4. 제안 방법론
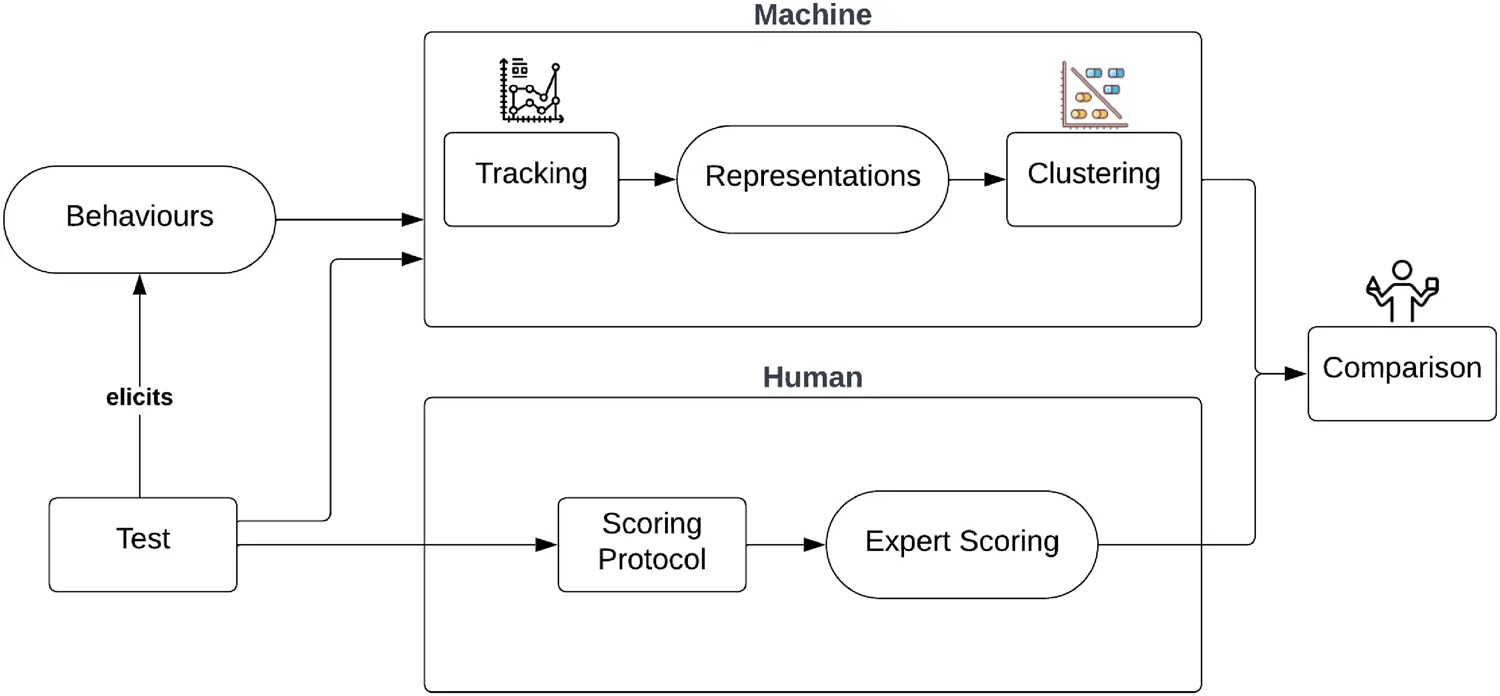
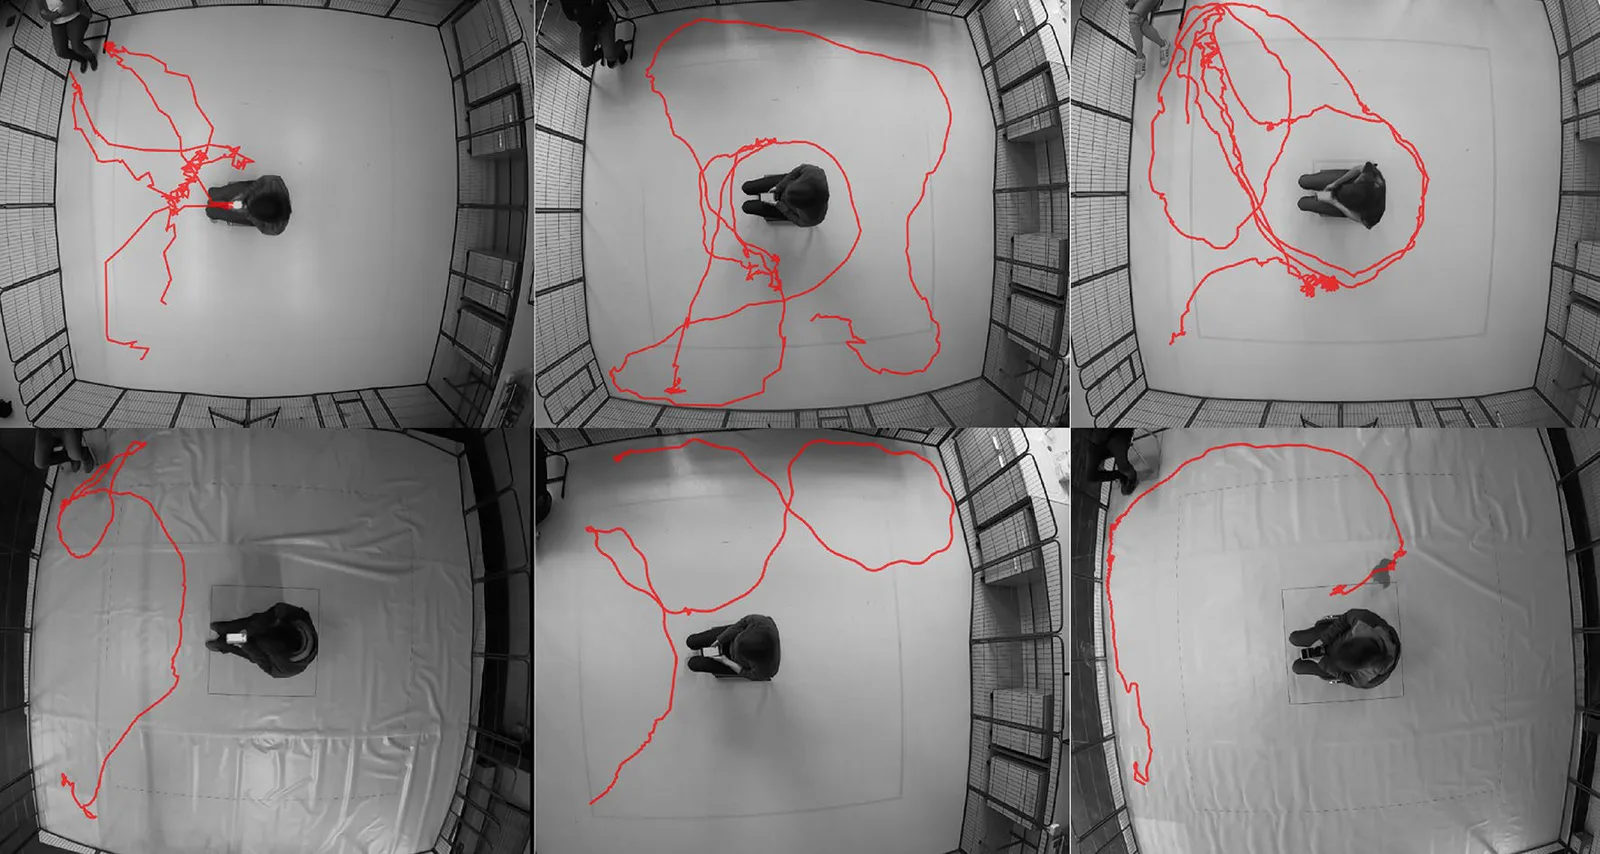
- 전체 접근 논리: 낯선 사람 앞에서 개가 보이는 위치 궤적에는 반응 정보가 있다고 가정하고, 궤적을 비지도 군집화한 뒤 군집을 전문가 점수와 설문에 맞추어 검증하고 지도학습 예측 모델로 확장했다.
- 단계:
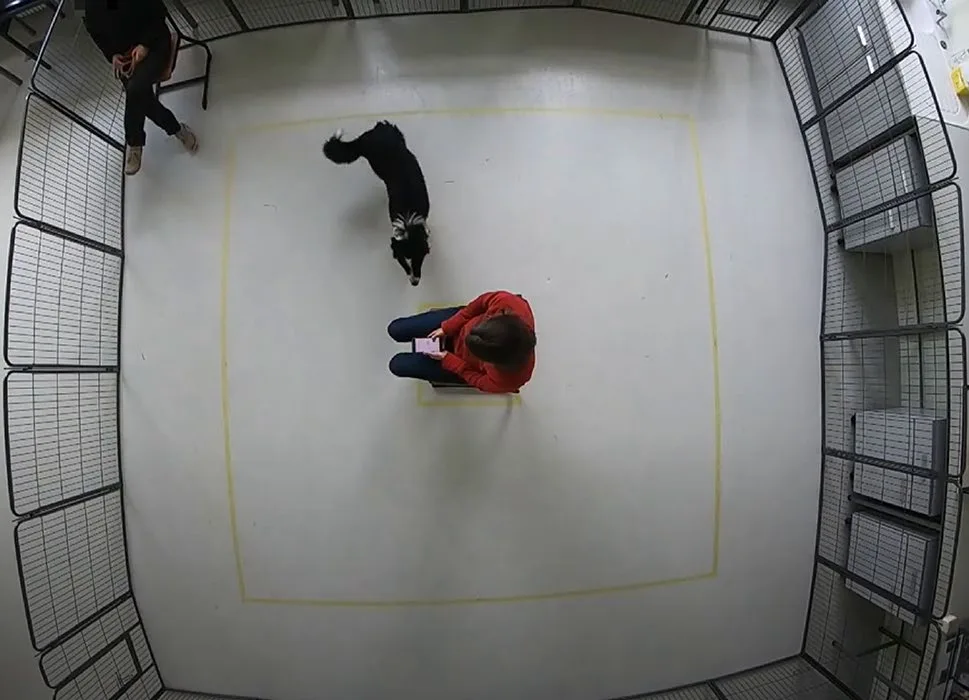
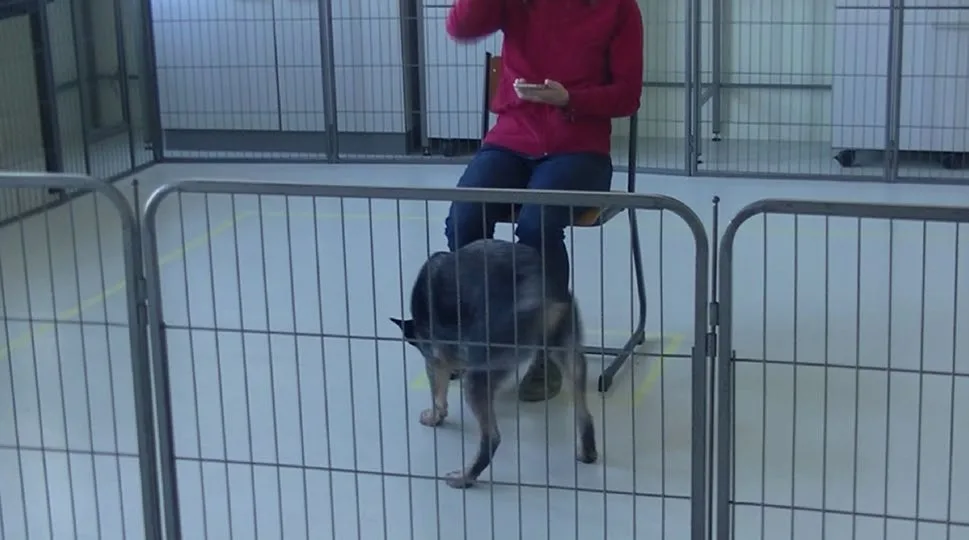
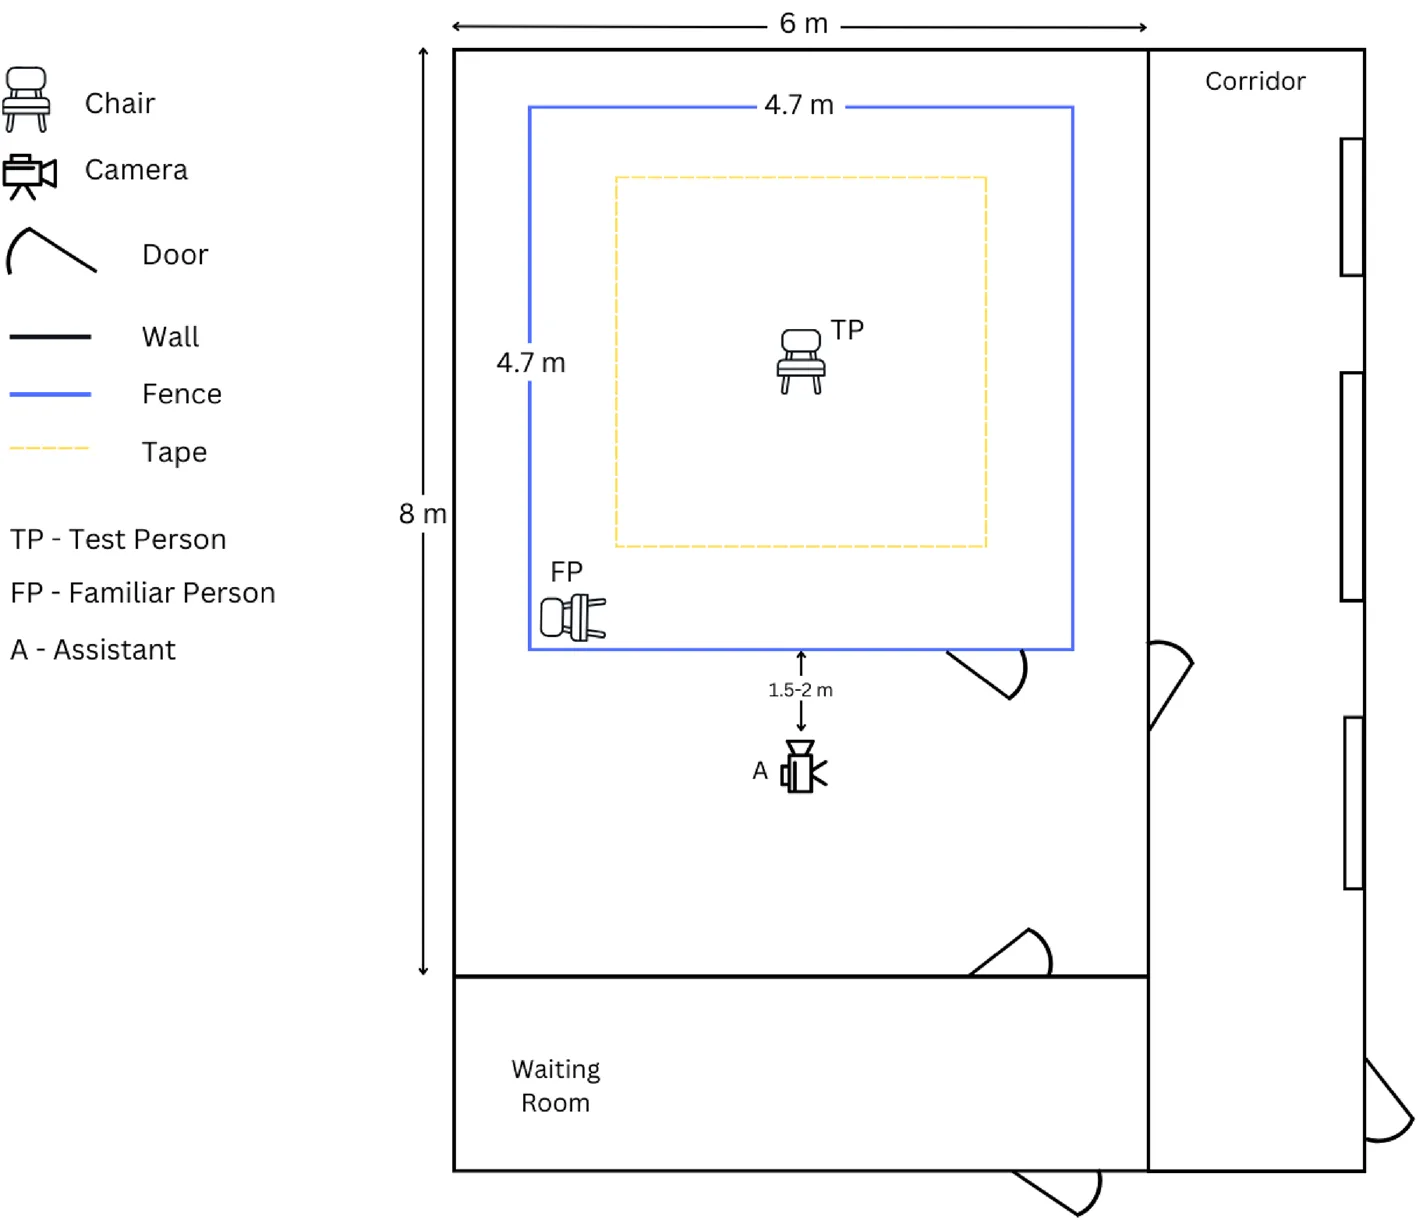
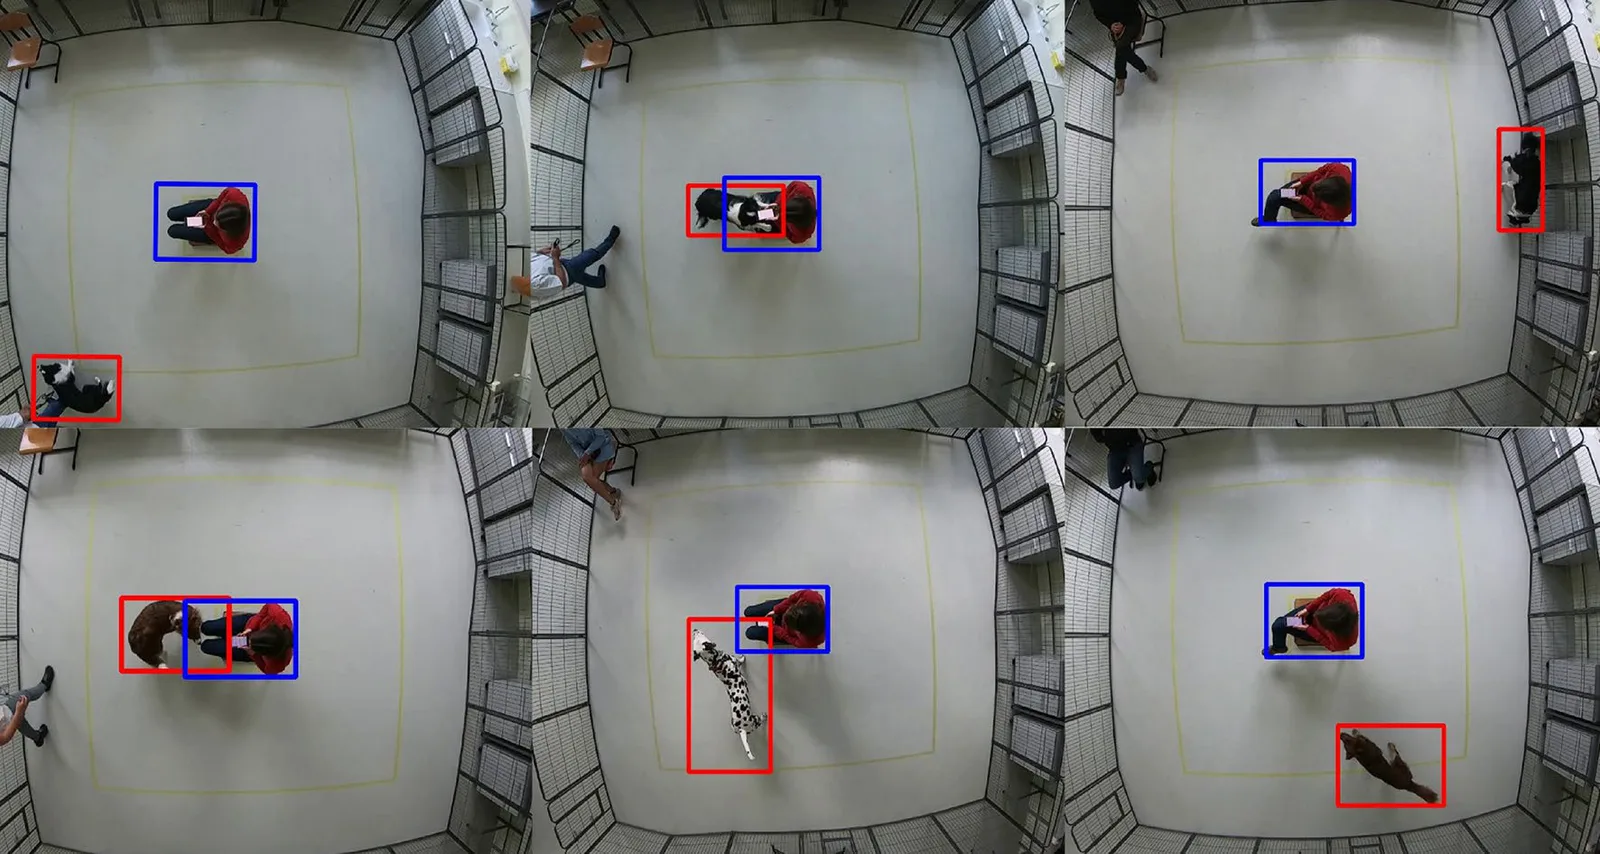
- 벨기에에서 스트레인저 테스트의 첫 단계(낯선 사람이 앉아 있다가 10초에 기침, 20초에 머리 쓸기, 30초에 다리 꼬기)를 실시하고 상부 및 측면 카메라로 촬영했다.
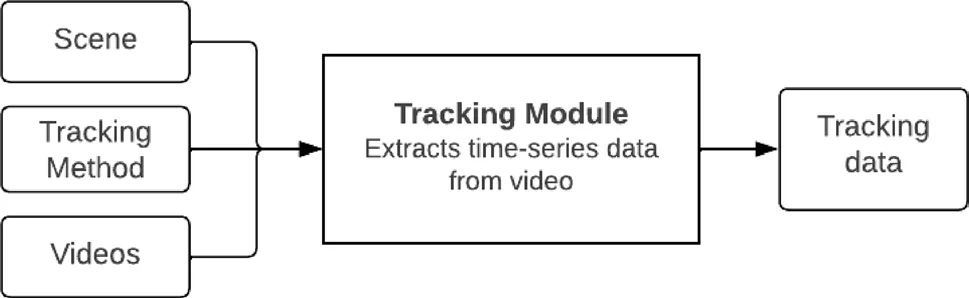
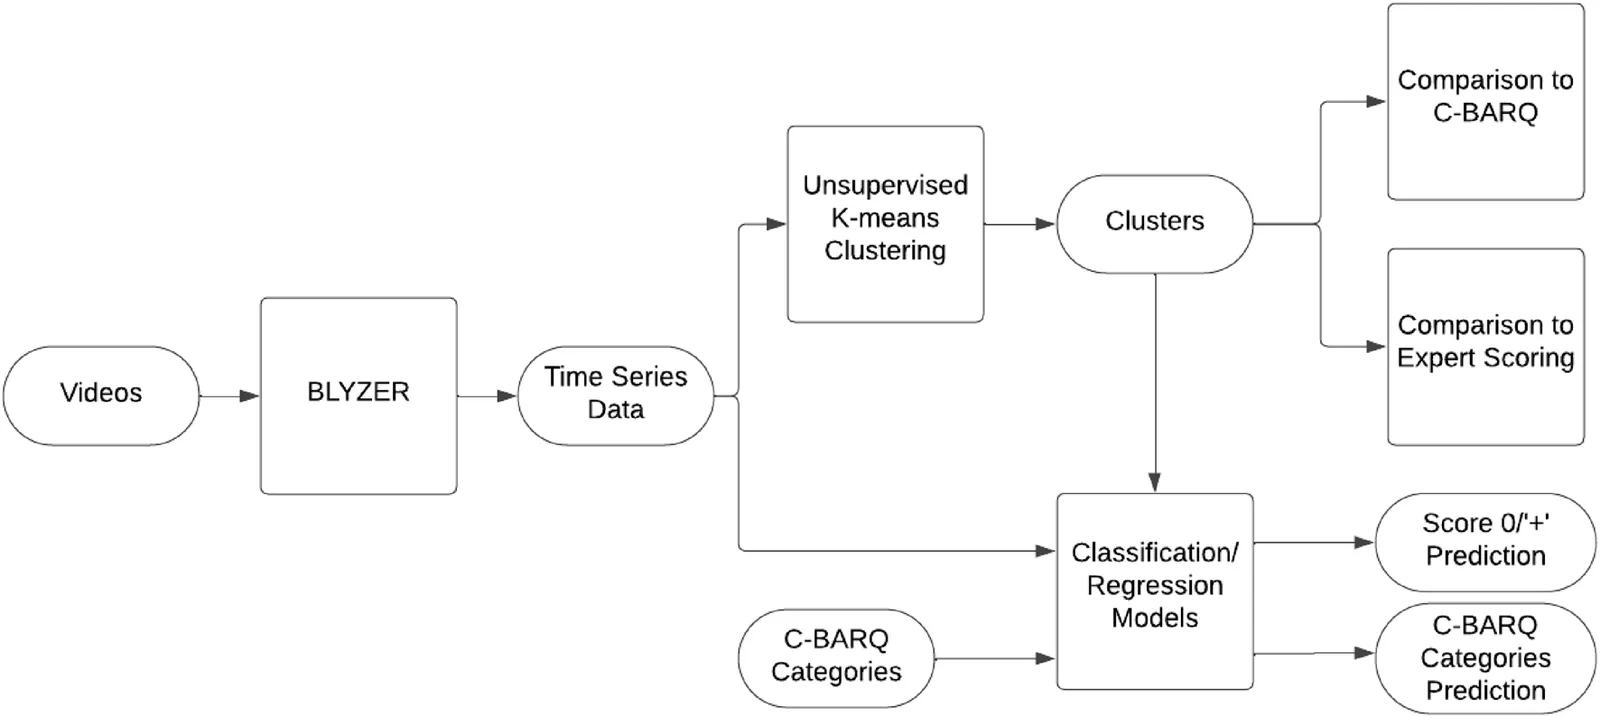
- BLYZER(COCO 2017 사전학습 Faster R-CNN을 개와 사람 이미지 106,768장으로 재학습)로 궤적을 추출하고 24 FPS로 맞추어 1차원 CNN 오토인코더로 변환했다.
- 시계열 K-means와 elbow 방법으로 군집을 정하고 Mann-Whitney U 검정으로 군집 간 C-BARQ를 비교했다.
- TPOT(최대 10,000개 파이프라인)로 전문가 점수 분류와 C-BARQ 8개 범주 회귀 모델을 구했다.
5. 실험 설정
| 항목 | 내용 |
|---|---|
| 대상/재료 | 벨기에에서 소셜미디어로 모집한 11-24개월령, 키 30-65 cm, 건강한 현대 품종 개 53마리(전문가 점수 분석 50마리, 영상 추적 품질 기준 통과 후 군집 분석 46마리) |
| 처리 조건 | 실내 4.7 x 4.7 m 울타리 안에서 낯선 사람(검사자)이 중앙에 앉아 중립적 행동 3가지를 하고 보호자는 구석에 앉아 있는 조건 |
| 대조군 | 해당 없음 |
| 측정 방법 | 전문가 3인의 5점 척도(-2~+2, 0/+/- 로 통합) 점수와 Fleiss kappa, C-BARQ 8개 범주(네덜란드어판), 궤적 군집, 정확도 등 분류 지표, MAE, MSE, R2 |
6. 실험 결과 분석
| 지표 | 변화(Δ) | 조건 · 유의성 |
|---|---|---|
| 전문가 평가자 간 일치도 | 일치율 85%, Fleiss free-marginal kappa 0.77 | n = 53, 3개 범주 |
| 전문가 점수 데이터 | 0점 32마리, + 점수 18마리, - 점수 3마리는 표본이 적어 제외 | 최종 50마리 |
| 군집과 전문가 점수 | 군집 1(26마리)은 0점 21, +점 5, 군집 2(20마리)는 0점 7, +점 13 | n = 46, 1마리는 이상치로 제외 |
| C-BARQ 낯선 사람 대상 공포 | 중앙값 군집 1 0.00, 군집 2 0.42 | Mann-Whitney U = 120.5, z = -2.56, p = 0.01. 다른 범주는 차이 없음 |
| 전문가 점수 분류 모델 | 정확도 0.787, 정밀도 0.771, 재현율 0.782, F1 0.775 | TPOT |
| C-BARQ 회귀: 보호자 대상 공격성 | MAE 0.108 (최저), MSE 0.046, R2 0.176 | TPOT 회귀 |
| C-BARQ 회귀: 흥분성 | MAE 0.122, MSE 0.032 (최저), R2 0.886 (최고) | TPOT 회귀 |
| C-BARQ 회귀: 낯선 사람 대상 공포 | MAE 0.510, MSE 0.430, R2 0.032 | 가장 낮은 성능 범주 중 하나 |
제안 기전(인과 사슬):
낯선 사람에 대한 개의 반응 → 위치 궤적 → 오토인코더 이동 공간 → 두 군집 (과도하게 반응하는 개와 중립적으로 반응하는 개) → 전문가 점수 및 C-BARQ와 연관
7. 비판적 평가
강점
- 사람이 고른 특징 없이 궤적 자체로 행동 프로파일을 도출했다.
- 전문가 3인의 높은 일치도(kappa 0.77)로 검증 기준을 확보했다.
한계 · 의문
- 참가 개체가 적고 - 점수(낯선 사람에게서 멀어지는 반응) 개체가 3마리뿐이어서 분석에서 제외되었다.
- C-BARQ는 보호자 보고이고 이 검사 상황이 아니라 개의 일반적 행동을 묻는다.
- 프로토콜의 한 단계만 사용했고 민감도와 재검사 신뢰도는 검토하지 않았다.
8. 향후 연구 방향
- 검사자가 이동하는 단계 등 프로토콜의 다른 단계와 측면 카메라의 미세 행동(응시, 입술 핥기)을 분석한다.
- 웨어러블 센서로 영상 분석을 대체하거나 보완한다.
- 더 큰 표본과 재검사 신뢰도 검증으로 확장한다.
9. 결론
궤적 기반 사람 없는 군집화는 전문가 점수와 부분적으로 일치했고, 전문가 점수를 78.7% 정확도로 예측했다. 탐색적 연구이므로 더 큰 표본에서의 검증이 필요하다.
Keywords
dog behavior assessment, machine learning, automated evaluation, behavioral clustering, C-BARQ, artificial intelligence, coping styles, behavioral classification
원문 그림
원문 그림 · 라이선스: cc-by