Animal Behavior
Efficacy of Edible and Leisure Reinforcers with Domestic Dogs
Efficacy of Edible and Leisure Reinforcers with Domestic Dogs
- 저자: Lazaro XA; Winter JM; Fernand JK; Cox DJ; Dorey NR
- 출처: - (2023)
- DOI/링크: https://doi.org/10.3390/ani13193073
- 연구 계열: Topics/Animal Behavior
- 투고일: 2023-08-03
TL;DR
가정견 10마리에서 선호도 평가로 고른 가장 선호하는 먹이와 놀이 물품 중 먹이가 더 강한 강화물로 작동했다. 점진비율(PR) 과제에서 먹이 조건이 놀이 물품 조건보다 반응률이 유의하게 높았고(t(30)=-6.32, p<0.001), 10마리 중 9마리가 먹이에서 더 많이 반응했다. 놀이 물품도 소거 조건보다는 높은 반응을 유지해 강화물로 기능했다.
1. 연구 배경 및 동기
- 다루는 문제: 선호도 평가는 훈련이나 중재에서 강화물이 될 만한 자극을 찾는 데 쓰이며, 개에서도 먹이 선호와 강화 효능의 관계가 확인되었다.
- 기존의 공백 / 왜 필요한가: 개에서 먹이와 놀이 물품(leisure item)의 강화 효능을 직접 비교한 연구가 없었다.
2. 관련 연구
- 기존 연구 흐름: 쌍자극 선호도 평가(PSPA)는 사람, 바퀴벌레, 거북이, 늑대, 개 등에서 쓰였고, 개에서 먹이 선호도가 점진비율 과제 반응과 달리기 속도를 예측함이 보고되었다.
- 이 논문의 위치: 개의 최상위 선호 먹이와 놀이 물품을 PSPA로 정하고 반응 조건과 점진비율 과제로 효능을 비교한 첫 연구이다.
3. 핵심 기여
- 먹이와 놀이 물품 각각의 선호도 평가를 한 개체에서 수행했다
- ABCABC 반전 설계와 점진비율 과제로 먹이가 놀이 물품보다 더 효과적인 강화물임을 보였다
- 선호도가 비슷해도 비율이 높아지면 먹이에서 반응이 더 유지됨을 보였다
4. 제안 방법론
- 전체 접근 논리: 먹이 6종과 놀이 물품 6종의 쌍자극 선호도 평가로 최상위 자극을 정한 뒤, 같은 행동(주먹에 코 대기)에 대해 먹이, 놀이 물품, 소거를 번갈아 제공하고(ABCABC), 이어 점진비율 스케줄에서 반응률을 비교했다.
- 단계:
- 각 먹이와 놀이 물품을 노출시킨 후 15회의 쌍자극 선호도 평가를 순서를 상쇄해 실시하고 가장 많이 선택된 자극을 최상위로 정함
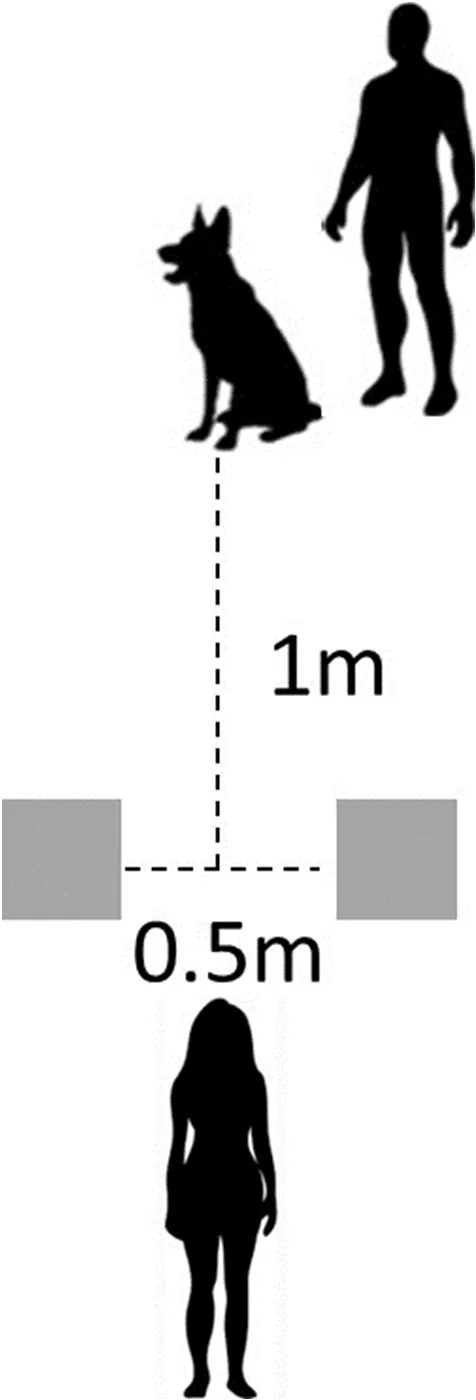
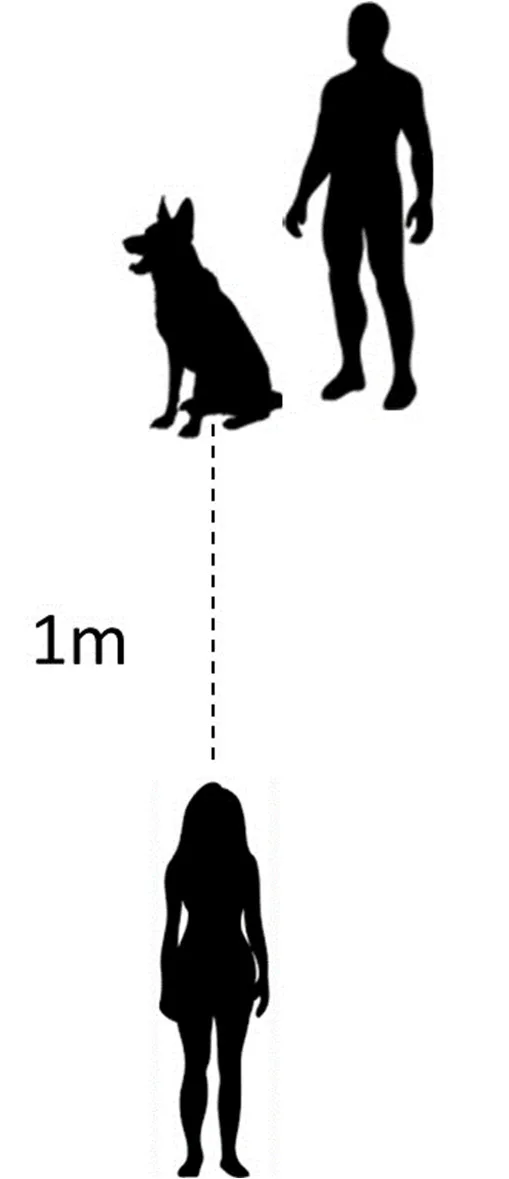
- 세 번째로 선호한 먹이로 실험자의 주먹에 코를 대는 행동을 1m 거리에서 훈련함
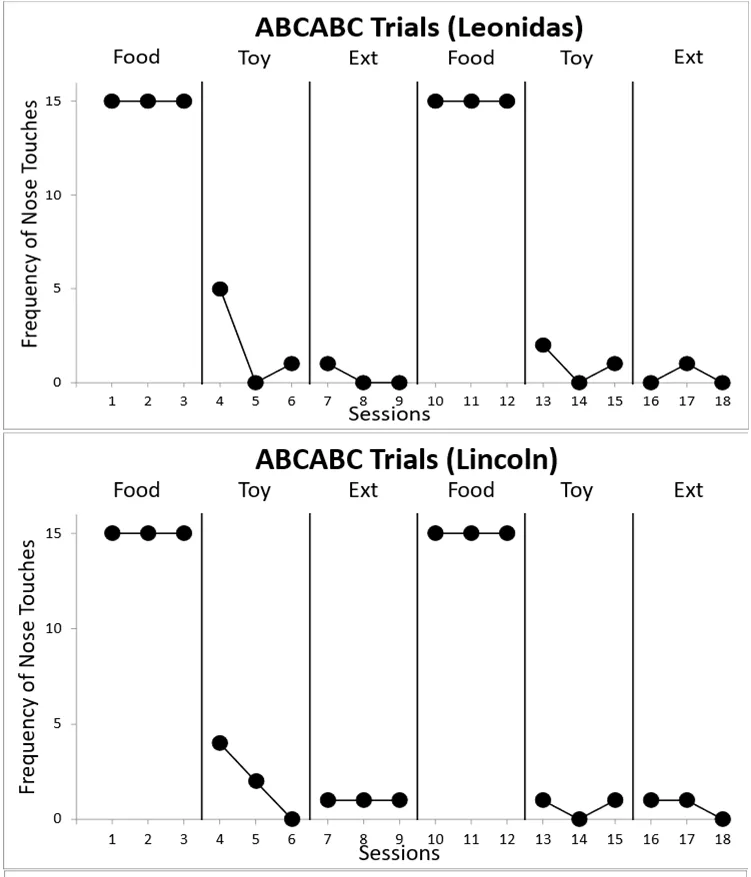
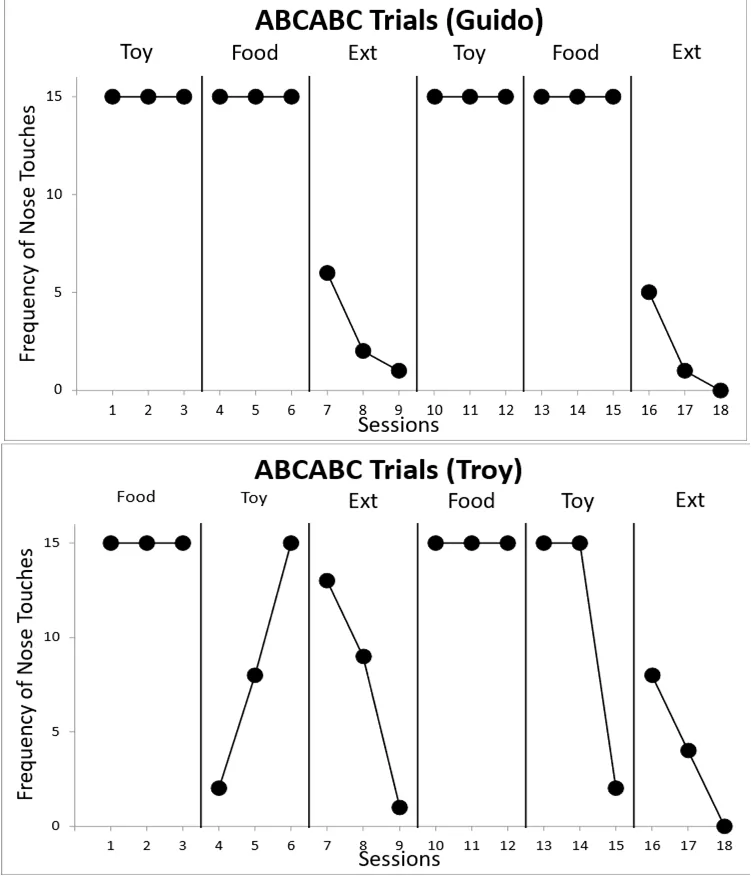
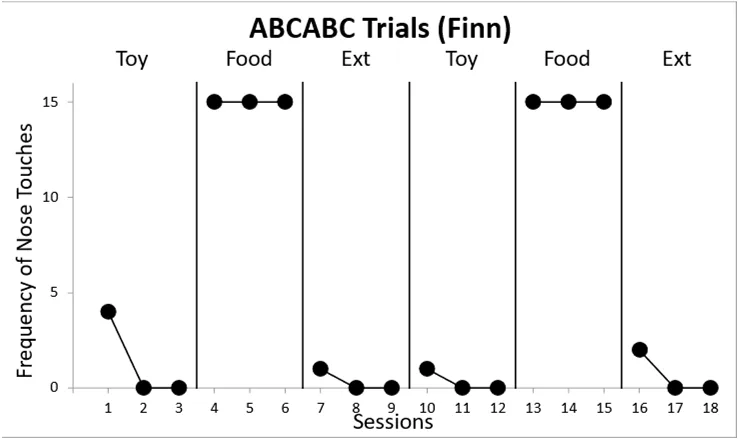
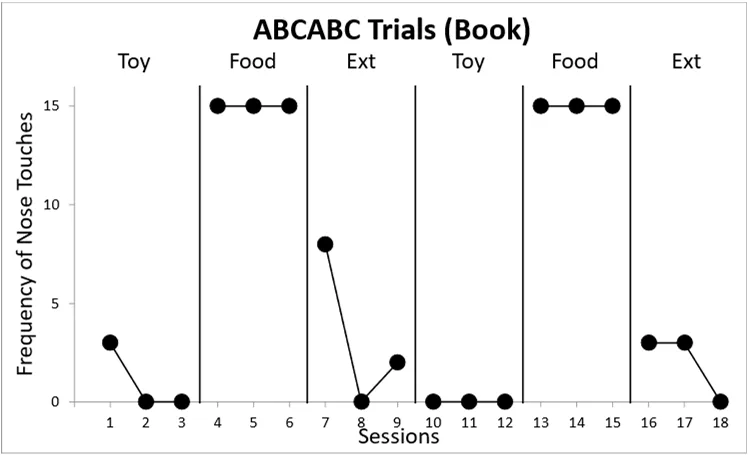
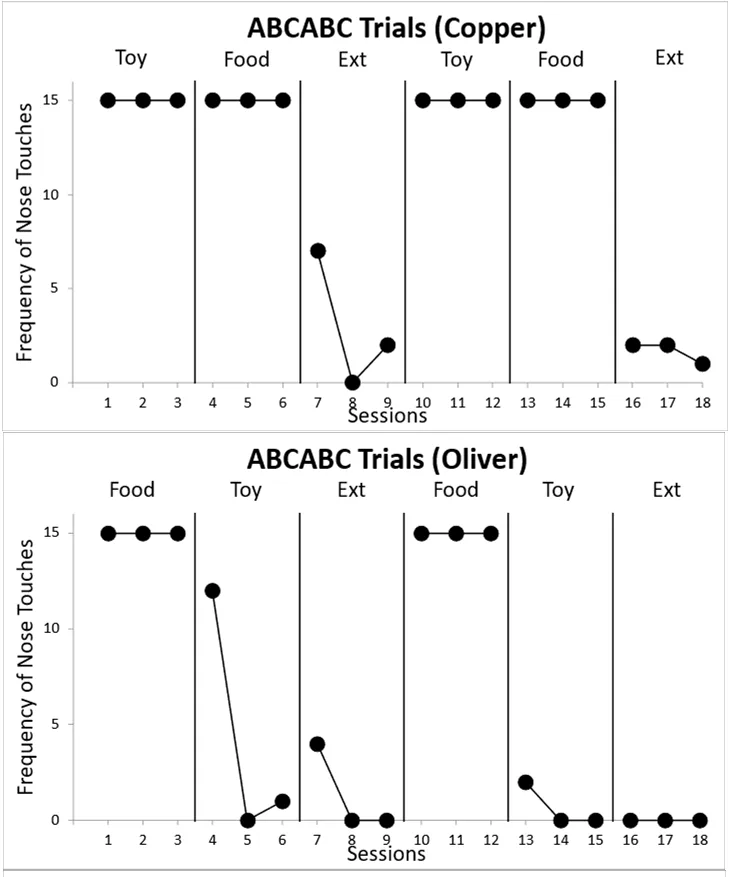
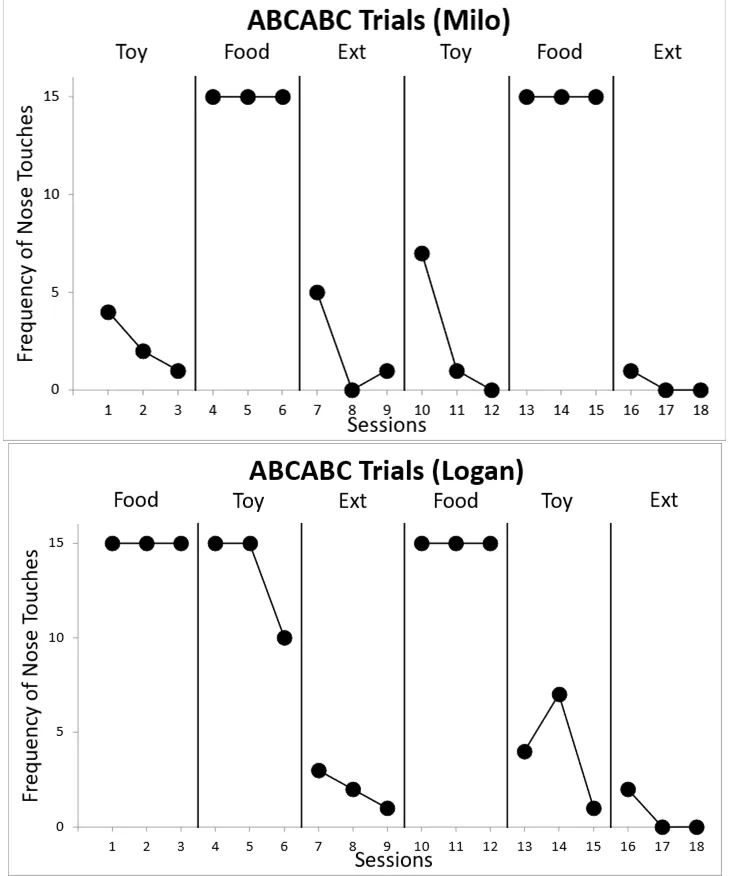
- ABCABC 단계: 먹이 강화, 놀이 물품 강화, 소거를 조건당 3세션(세션당 최대 15시행)으로 반복. A와 B 순서는 개체 간 상쇄
- 점진비율 단계: 먹이와 놀이 물품 조건 각각 3세션, 반응 요구 횟수를 시행마다 1, 2, 3으로 늘림. 반응 없이 1분, 2m 이탈 5초, 머리를 바닥에 대면 종료
5. 실험 설정
| 항목 | 내용 |
|---|---|
| 대상/재료 | 가정견 10마리(수컷 8·암컷 2, 11개월~8세; 믹스 6, 저먼 셰퍼드 2, 래브라도 1, 저먼 쇼트헤어드 포인터 1; 연령 1마리 NA). 소셜미디어와 입소문으로 모집, 익숙한 방해 없는 공간에서 검사. |
| 처리 조건 | 먹이 후보: 핫도그, 당근, 치즈, 키블, 딱딱한 간식, 부드러운 간식(약 1cm 입방체). 놀이 물품 후보: 공, 줄다리기 장난감, 삑삑이 장난감, 뼈, 인형, 빈 페트병. 검사 전 4시간 이상 급식 제한. 최상위 먹이는 딱딱한 간식 5마리·핫도그 2·부드러운 간식 2·당근 1, 최상위 놀이 물품은 인형 4·공 4·페트병 1·플라스틱 뼈 1. |
| 대조군 | 소거 조건(빈 손을 보여 주고 보상 없음)과 개체 내 비교. 첫 조건은 먹이 5마리, 놀이 물품 5마리로 상쇄. |
| 측정 방법 | 코 터치 횟수(반응률), 시행 수, 선호도 평가 선택 비율. 점진비율 과제 반응률은 대응 t 검정으로 비교. |
6. 실험 결과 분석
| 지표 | 변화(Δ) | 조건 · 유의성 |
|---|---|---|
| ABCABC 단계 시행 수 | 먹이 조건에서는 모든 개체가 15시행 도달. 놀이 물품과 소거 조건에서는 거의 도달하지 못함. 먹이·놀이 두 조건에서 모두 15시행 도달한 개체는 Copper와 Guido 2마리 | n=10 |
| 점진비율 과제 반응률: 먹이 vs 놀이 물품 | 먹이 조건이 놀이 물품 조건보다 유의하게 높음 | 대응 t 검정 t(30)=-6.32, p<0.001 |
| 개체별 점진비율 반응 | 10마리 중 9마리(90%)가 먹이에서 더 많이 반응. Troy만 놀이 물품에서 높았으나 유의하지 않음. 7마리(70%)는 조건 간 반응률 차이가 유의, Logan·Troy·Copper는 유의하지 않음 | 그림 5 |
| 놀이 물품의 강화 기능 | 놀이 물품에 대한 반응이 소거 조건보다 높아 강화물로 작동했으나 먹이 조건에서 더 많은 시행을 수행 | 수치는 그림으로만 제시 |
7. 비판적 평가
강점
- 선호도 평가와 두 가지 강화 효능 평가(반전 설계, 점진비율)를 개체 내에서 결합했다
- 조건 순서를 상쇄하고 자극별 장갑 색으로 조건을 구분했다
한계 · 의문
- 10마리로 표본이 작고 자극 후보를 연구자가 정했다
- 먹이와 놀이 물품을 동시에 제시하지 않아(단일 조작 설정) 병행 선택 상황의 결과는 알 수 없다
- 수색구조견처럼 놀이 물품으로 일해 온 개는 포함되지 않았다
8. 향후 연구 방향
- 수색구조견 등 놀이 물품으로 강화받은 이력이 있는 개에서 같은 비교
- 훈련 목표(활동적 명령 vs 정적 명령)와 개체에 따라 보상이 달라지는지 검증
9. 결론
개에게는 평균적으로 먹이가 놀이 물품보다 강력한 강화물로 작동했고, 선호도 평가에서 비슷한 선호를 보인 개도 요구 반응이 늘어나면 먹이에 더 반응했다. 다만 놀이 물품도 강화물로 기능했으며 최적의 보상은 개체와 훈련 목표에 달려 있다고 저자들은 논의한다.
Keywords
domestic dog, preference assessment, reinforcer, food, leisure items, training, reversal design
원문 그림
원문 그림 · 라이선스: cc-by